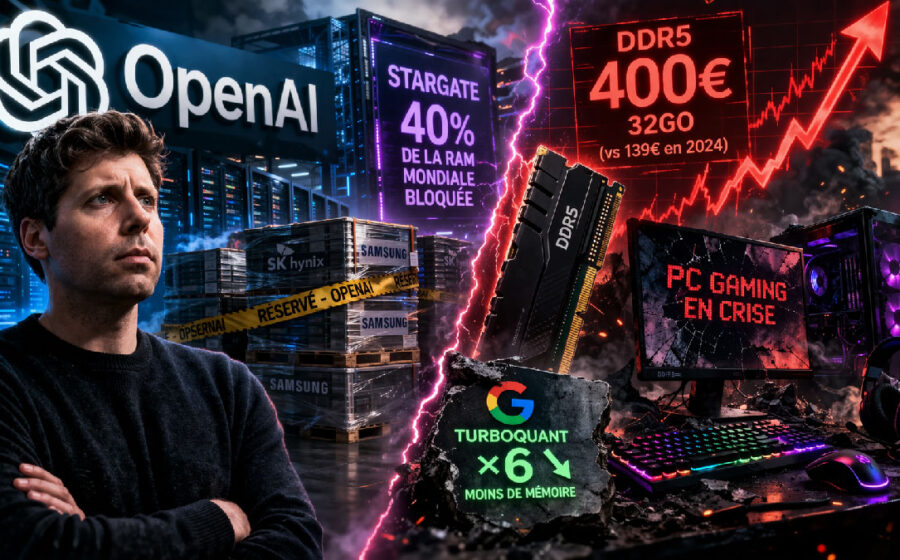
Sam Altman, CEO da OpenAI, classificou a execução de modelos de IA em computadores pessoais como uma “péssima alocação de recursos globais”. A declaração, dada no podcast do cofundador da Stripe, John Collison, expõe um conflito direto entre a soberania de dados do usuário e a escassez crítica de memória de alta largura de banda (HBM).
O argumento central é brutalmente simples: a memória DRAM ociosa em milhões de PCs domésticos poderia alimentar data centers que operam a 100% da capacidade. Mas a conta fecha para quem?
O cálculo do desperdício: 5% de utilização
Altman citou um número específico para embasar a crítica: a memória RAM de um computador pessoal médio é utilizada apenas 5% do tempo. Em um cenário onde a produção global de DRAM não acompanha a demanda por chips de IA, segundo ele, cada gigabyte alocado em uma máquina ociosa é um gigabyte roubado da inferência em nuvem.
A lógica do executivo reflete a ótica de um hyperscaler: concentração máxima para eficiência máxima. Data centers não dormem; laptops, sim.
A crise da DRAM em números reais
Não é apenas retórica. O mercado de memória vive um choque de oferta sem precedentes:
- Preços: Subiram entre 90% e 95% no primeiro trimestre de 2026 (dados TrendForce).
- Oligopólio: Micron, Samsung e SK Hynix controlam praticamente toda a produção mundial.
- Prioridade: As fabricantes limitam chips de consumo para priorizar HBM (High Bandwidth Memory), essencial para GPUs de data center.
Montar uma nova fábrica de memória de ponta leva anos e bilhões. A China tenta há meses entrar nesse jogo, mas esbarra na complexidade técnica dos nós avançados.
A jogada das Big Techs: silício próprio
Diante do gargalo, a solução não é esperar o mercado — é verticalizar. A OpenAI desenvolve o chip “Jalapeño” em parceria com a Broadcom. Google (TPUs), Amazon (Trainium/Inferentia), Meta, Microsoft e até a SpaceX seguem o mesmo roteiro: silício customizado que espreme cada gota da DRAM disponível.
Otimização de arquitetura vira vantagem competitiva quando o insumo básico é escasso.
A contradição do “open source”
Aqui a narrativa vira ironia. Em agosto de 2025, a OpenAI lançou o gpt-oss, seus primeiros pesos abertos desde o GPT-2, desenhados justamente para rodar localmente. Meses antes, Altman admitira que a empresa estivera do “lado errado da história” sobre código aberto.
O lançamento aconteceu antes da crise de DRAM explodir nos preços atuais. Hoje, o executivo argumenta que o contexto mudou: o “luxo” da inferência local tornou-se insustentável para a cadeia global.
Por que usuários e empresas insistem no local?
Apesar do apelo de Altman, a migração para a borda (edge) não vai recuar. Três pilares sustentam a resistência:
- Privacidade e compliance: Dados sensíveis não saem da rede corporativa.
- Latência zero e offline: Crítico para indústria, defesa e robótica.
- Custo marginal zero: Hardware já comprado (sunk cost) vs. token pago por API.
Para o CTO que precisa rodar um modelo 7B em um servidor interno isolado, a “eficiência global da DRAM” é um problema abstrato. A conformidade regulatória é concreta.
O que observar daqui para frente
O cabo de guerra está montado: de um lado, a pressão dos hyperscalers para centralizar capacidade e justificar investimentos bilionários em silício próprio; do outro, a democratização do hardware de consumo (NPUs integradas, GPUs com 24GB+ VRAM) que torna a inferência local tecnicamente viável e economicamente atrativa.
Três sinais para monitorar nos próximos trimestres:
- Curva de preços da HBM vs. DDR5 de consumo — o spread indica para onde a capacidade fabril está fluindo.
- Cronograma de tape-out do chip “Jalapeño” e equivalentes — silício próprio alivia a dependência de Nvidia, mas não da DRAM.
- Adaptação de licenças de modelos abertos — restrições de uso comercial podem forçar empresas de volta à nuvem.
A “terrível alocação” de Altman é, para o usuário final, a única alocação que garante soberania. O mercado decidirá qual escassez dói mais: a de silício ou a de confiança.