Uma falha global na infraestrutura da Microsoft deixou empresas e governos sem acesso a e-mails, reuniões e ferramentas de IA desde a quinta-feira (12). Mais de 16 horas depois, a big tech admite que a capacidade dos serviços “ainda não voltou aos níveis normais”. O que começou como um inconveniente técnico já derrubou divulgações de resultados e travou sistemas de saúde e segurança.
O impacto direto no seu dia a dia depende de qual nuvem sua organização roda. Mas a lição estrutural já está posta: depender de um único provedor para comunicação, colaboração e inteligência artificial cria um ponto único de falha em escala planetária.
O que parou e quem sentiu na pele
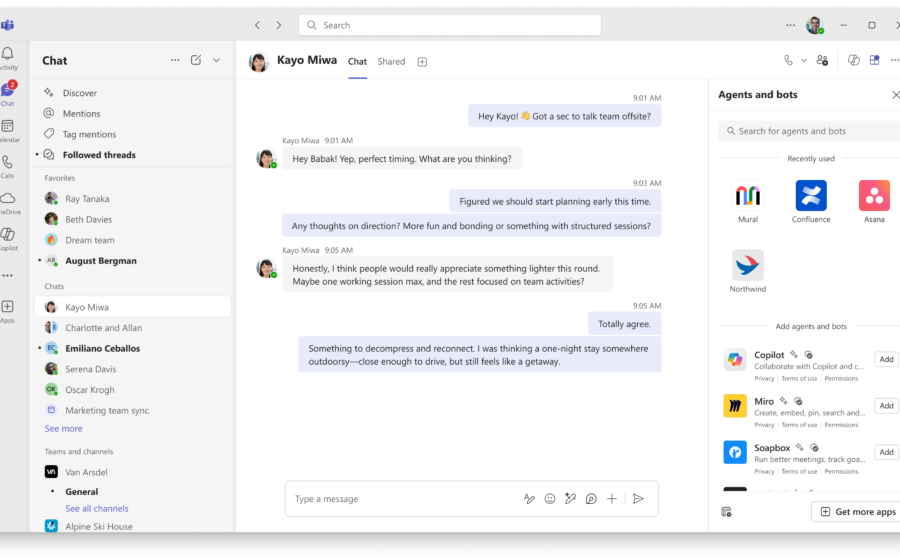
A interrupção atingiu o pacote Microsoft 365 por inteiro: Outlook, Teams, Copilot e conectores usados por parceiros como OpenAI e Anthropic. Na prática, isso significa:
- E-mails não entram nem saem — nem pelo app, nem pelo navegador.
- Reuniões no Teams caem ou nem iniciam.
- Assistentes de IA integrados ao fluxo de trabalho ficam mudos.
- Integrações de terceiros que usam conectores do 365 retornam erro.
O grupo suíço Richemont (dono da Cartier e Chloé) adiou a divulgação de resultados semestrais. A Workhorse Group, de caminhões elétricos, segurou o balanço trimestral. No setor público, o NHS britânico orientou pacientes a ligar em vez de enviar e-mail; a polícia e a inteligência australianas relataram falhas; o governo japonês viu sua infraestrutura compartilhada de TI oscilar; e a Nova Zelândia perdeu capacidade de receber e-mails em todas as embaixadas.
Por que a recuperação demora tanto
Charles Lamanna, vice-presidente executivo de Copilot, Agentes e Plataforma, descartou ataque cibernético. A causa raiz não foi detalhada publicamente, mas a extensão do estrago sugere falha em camada base — identidade, roteamento ou armazenamento — que cascateia para todos os serviços acima.
Diferente de uma queda isolada no Exchange ou no Teams, desta vez o plano de controle comum a todo o ecossistema 365 foi comprometido. Isso explica por que “primeiros sinais de estabilização” não se traduzem em normalização: cada serviço precisa ser validado individualmente após o núcleo voltar.
O custo invisível para quem não parou
Mesmo organizações que mantiveram operação via contingência (WhatsApp, Slack, Gmail, Zoom) pagam um preço: retrabalho para sincronizar decisões tomadas fora do sistema de registro, risco de compliance em comunicações informais e perda de telemetria de produtividade que o próprio 365 geraria.
Para investidores e conselhos, a métrica a observar não é apenas o SLA contratual, mas o tempo médio para recuperação total (MTTR) em incidentes de camada base. Histórico recente mostra que falhas assim costumam deixar resíduos de instabilidade por 24 a 48 horas após o “verde” no painel de status.
O que observar daqui para frente
Três movimentos práticos merecem atenção nas próximas semanas:
- Revisão de contratos e SLAs: cláusulas de indenização por indisponibilidade prolongada tendem a ser acionadas — ou renegociadas na renovação.
- Estratégia de multi-cloud para identidade e comunicação: provedores de IdP (Okta, Entra ID, Ping) e de colaboração (Slack, Zoom, Google Workspace) ganham espaço como camada de resiliência.
- Planos de continuidade testados: a diferença entre “temos um plano” e “simulamos queda total do 365 por 24h” separa quem parou de quem manteve o negócio rodando.
O comunicado da Microsoft sobre “estabilização inicial” saiu na sexta à tarde, horário de Brasília. Se o padrão histórico se repetir, o fim de semana será de limpeza de filas de e-mail, sincronização de calendários e validação de logs de auditoria. Para o gestor que lê isto na segunda-feira: a pane já acabou, mas o trabalho de consequência está só começando.