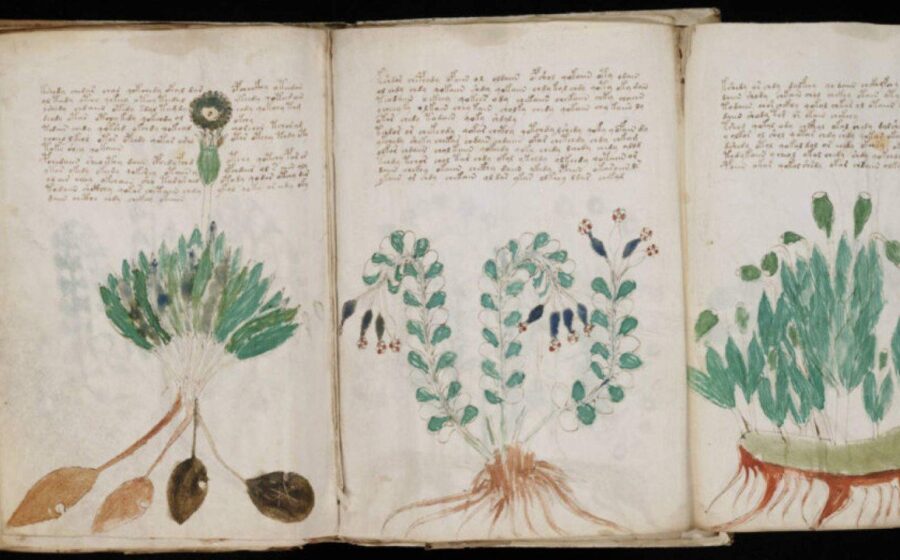
A inteligência artificial está sendo testada contra o Manuscrito Voynich, um códice de 240 páginas escrito no início de 1400 que resiste a qualquer tradução há mais de um século. Algoritmos avançados confirmaram que o texto possui estrutura linguística real, não aleatória. Mas a ausência de uma “Pedra de Roseta” digital mantém o significado trancado.
O documento repousa na Biblioteca Beinecke, em Yale, desde 1969. Sua tinta e pergaminho foram datados por carbono-14 entre 1404 e 1438. Nele, um alfabeto desconhecido convive com desenhos de plantas que não existem, diagramas astronômicos e figuras nuas em banhos termais.
O fim da tese da farsa aleatória
Por décadas, a hipótese principal era a de uma fraude renascentista: gibberish visual para enganar compradores ingênuos. A análise estatística via machine learning derrubou essa ideia. O texto obedece à Lei de Zipf, padrão universal onde poucas palavras aparecem muito e a maioria aparece pouco — assinatura digital de línguas naturais humanas.
Além disso, a distribuição vocabular muda conforme a ilustração da página. Termos na seção botânica diferem estatisticamente dos termos na seção astronômica. Isso indica intenção semântica, não decoração.
Por que a IA ainda falha
Modelos de linguagem grandes (LLMs) aprendem com bilhões de textos paralelos. O Voynich oferece zero texto paralelo. Não há versão em latim, grego ou árabe ao lado. É o problema do “aprendizado supervisionado sem rótulos”.
- Entropia alta: O sistema de escrita tem variabilidade compatível com línguas reais, mas não mapeável.
- Sem âncora bilíngue: Diferente dos hieróglifos (decifrados via Pedra de Roseta), não existe chave conhecida.
- Viés de confirmação: Algoritmos tendem a forçar correspondências com idiomas do treinamento, gerando “traduções” plausíveis e falsas.
Segundo Romes Heriberto, professor de Engenharia de Software no Uniceplac, “a IA funciona como uma lupa estatística poderosa, mas lupa não decifra código sem chave”. Leo Soares, especialista em IA, completa: “Estrutura não é significado. O risco é validar uma interpretação elegante que não passa de alucinação computacional”.
A pista do código Naibbe
Em 2025, o pesquisador Michael Greshko demonstrou que um método de cifragem manual do século 15 — o código Naibbe, baseado em dados e cartas — replica em latim e italiano as mesmas propriedades estatísticas do Voynich. Isso inclui a Lei de Zipf e a segregação vocabular por tema.
A descoberta reacende a hipótese de cifra artificial renascentista. Não seria língua natural extinta, nem nonsense: seria um sistema criptográfico deliberado, desenhado para parecer idioma.
O que observar daqui para frente
A quebra do Voynich não virá apenas de mais GPU ou transformers maiores. Dependerá de achados em arquivos físicos: diários de alquimistas, correspondências de Rudolf II (que comprou o manuscrito por 600 ducados em 1599) ou anotações marginalias em outros códices da época.
Para investidores e gestores de inovação, o caso é um lembrete brutal: dados sem contexto histórico são ruído. A próxima fronteira da IA generativa não é apenas escalar parâmetros, mas integrar evidências documentais escassas — o “small data” que o big data ignora. Quem resolver esse gap metodológico não decifra apenas um livro medieval; desbloqueia a análise de qualquer corpus órfão de rótulos, de logs industriais legados a sinais de sensores sem documentação.